18Caso 1. Riesgo de reintroducción de sarampión y rubéola
NotaAntes de empezar
Responde sin consultar el texto. Al terminar, vuelve a esta pregunta y comprueba si cambió tu respuesta.
1. Para clasificar el riesgo de reintroducción del sarampión en un cantón, ¿qué combinación de información es más útil?
Inmunidad de la población y capacidad de la vigilancia para detectar un caso
Solo la cobertura de SRP1
Solo el número de casos sospechosos
Solo el tamaño de la población
TipRespuesta de la pregunta 1
a. Un cantón con baja inmunidad es más peligroso si además un caso pasaría inadvertido.
18.1 La situación
Un país vecino notifica un brote de sarampión. La dirección distrital pide, para la reunión del lunes, una clasificación de sus cinco cantones según el riesgo de que un caso importado inicie transmisión, y una propuesta de dónde intensificar la vacunación y la vigilancia. Los datos son el registro nominal (sintético) de los capítulos anteriores y un consolidado de vigilancia semanal (también sintético).
ImportanteUn ejercicio, no la herramienta oficial
La OPS dispone de una herramienta de análisis de riesgo de sarampión y rubéola, con versión en R, que suma puntos de cinco componentes (inmunidad de la población, calidad de la vigilancia, desempeño programático, amenaza y respuesta rápida) en una escala de 0 a 100 para cada municipio (Organización Panamericana de la Salud, 2025). Este caso construye un puntaje didáctico simplificado para entender la lógica. Para una evaluación real debe usarse la herramienta vigente de la OPS, con sus indicadores y puntos de corte.
Un cantón con baja inmunidad es más peligroso si además un caso pasaría inadvertido. El consolidado sintético registra, por cantón y semana, los casos sospechosos de sarampión o rubéola notificados y si los establecimientos enviaron la notificación semanal, incluida la negativa («esta semana no hubo casos»). Para generarlo suponemos una población total de 70 habitantes por cada nacimiento anual, un supuesto que solo sirve para el ejercicio:
Las tasas de notificación son inestables: con poblaciones de este tamaño, uno o dos casos sospechosos en tres años cambian la cifra por completo. Por eso, además de la tasa, usamos el cumplimiento de la notificación semanal, un indicador que existe aunque no haya casos y que mide si el sistema está mirando. En C04 no se notificó nada, ni siquiera la ausencia de casos, en 37,8 % de las semanas.
18.4 Paso 3. Un puntaje didáctico
Cada indicador recibe 0, 1 o 2 puntos de riesgo, y la suma (de 0 a 8) se agrupa en cuatro niveles: bajo (0 a 2), medio (3 a 4), alto (5 a 6) y muy alto (7 a 8). Los cortes son elegidos para el ejercicio y deben reemplazarse por los de la herramienta oficial:
  canton srp1 srp2 pct_sin_dosis pct_semanas_notificadas puntaje    nivel
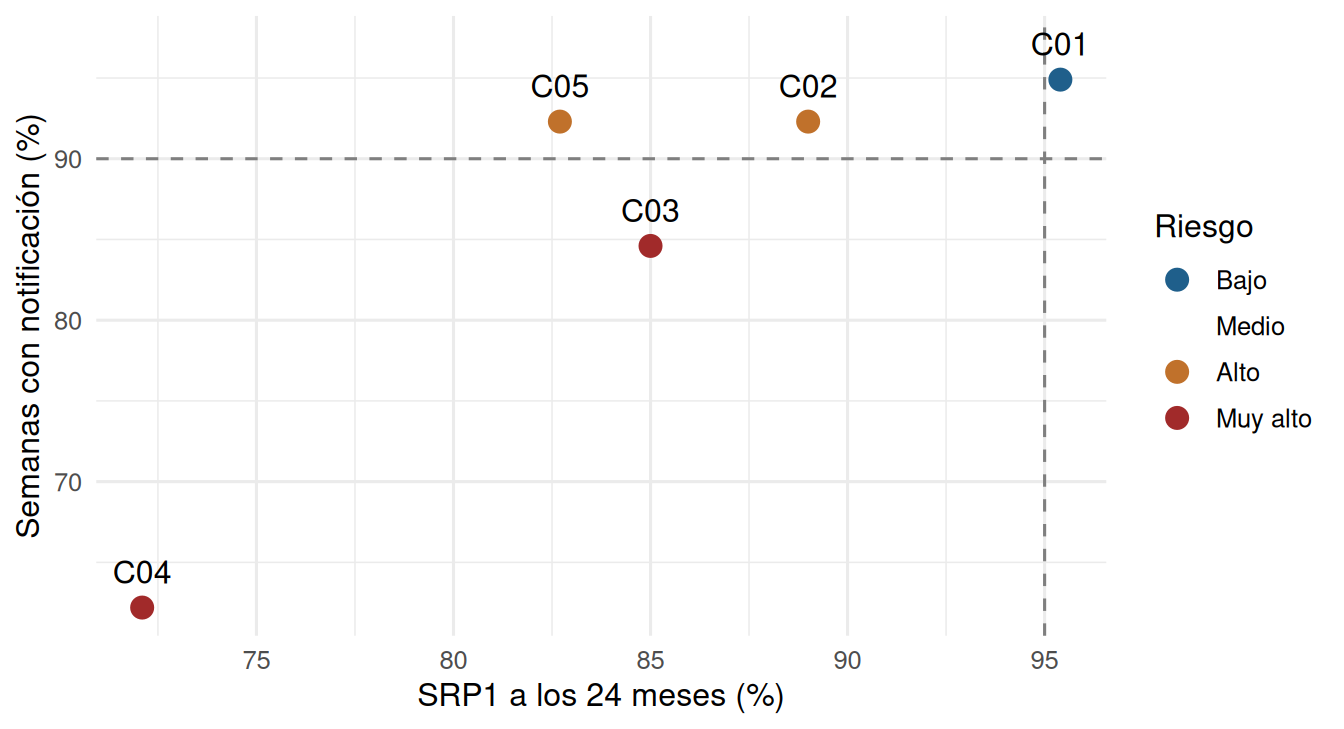
4    C04 72.1 70.0          34.9                    62.2       8 Muy alto
3    C03 85.0 84.2          16.2                    84.6       7 Muy alto
2    C02 89.0 86.1          11.3                    92.3       6     Alto
5    C05 82.7 79.8          14.3                    92.3       6     Alto
1    C01 95.4 93.6           6.1                    94.9       2     Bajo
ggplot(riesgo, aes(srp1, pct_semanas_notificadas, colour = nivel, label = canton)) +geom_vline(xintercept =95, linetype =2, colour ="grey50") +geom_hline(yintercept =90, linetype =2, colour ="grey50") +geom_point(size =3.5) +geom_text(nudge_y =2.2, colour ="black") +scale_colour_manual(values =c(Bajo ="#1f5f8b", Medio ="#d4a017", Alto ="#c0712b", "Muy alto"="#a12a2a"),drop =FALSE) +labs(x ="SRP1 a los 24 meses (%)", y ="Semanas con notificación (%)", colour ="Riesgo") +theme_minimal(base_size =12)
Figura 18.1: Cobertura de SRP1 a los 24 meses y cumplimiento de la notificación semanal por cantón. El color indica el nivel del puntaje didáctico. Datos sintéticos.
18.5 Paso 4. Sensibilidad de la clasificación
Un puntaje con cortes arbitrarios puede cambiar de categoría por medio punto de cobertura. Antes de presentarlo, comprobemos qué pasa si cada cobertura fuera dos puntos más alta o más baja:
  canton  menos_2 observado    mas_2
1    C01    Medio      Bajo     Bajo
2    C02     Alto      Alto     Alto
3    C03 Muy alto  Muy alto Muy alto
4    C04 Muy alto  Muy alto Muy alto
5    C05     Alto      Alto     Alto
Los cantones que no cambian de nivel tienen una clasificación sólida. Los que cambian están cerca de un corte, y conviene presentarlos con esa salvedad, por ejemplo: «riesgo bajo o medio según la precisión de la cobertura».
18.6 Conclusiones para el programa
C04 concentra el mayor riesgo: la cobertura más baja de SRP, la mayor proporción de niños mayores de 12 meses sin ninguna dosis (34,9 %) y la vigilancia más débil. Si llegara un caso, sería el cantón con más susceptibles y con menos probabilidad de detectarlo a tiempo. Corresponde una búsqueda activa de niños sin SRP con la lista nominal del registro y una revisión de la notificación semanal con los establecimientos.
Los cantones con buena cobertura pero algún establecimiento silencioso necesitan sobre todo fortalecer la vigilancia.
La clasificación usa datos infantiles: no dice nada de adolescentes y adultos susceptibles, que en los brotes de la región suelen tener un papel importante y requieren otras fuentes.
18.7 Ejercicios
Nivel 1: reproducir
Cambia la semilla del consolidado de vigilancia (set.seed(51)) y vuelve a calcular el puntaje. ¿Qué cantones cambian de nivel?
Agrega al puntaje la tasa anual de sospechosos con un punto si es menor de 1 por 100.000. ¿Mejora o empeora la clasificación, dado lo inestable de esa tasa?
Nivel 2: adaptar
Reemplaza los cortes de cobertura por 92 % y 85 %. Documenta la decisión y compara las clasificaciones.
Calcula el puntaje por establecimiento en lugar de por cantón. ¿Qué problema aparece con el número de niños?
Nivel 3: decidir
Con un presupuesto para una sola acción en el distrito, ¿propondrías una campaña de seguimiento en C04 o una búsqueda nominal de niños sin SRP en todos los cantones? Justifica con los resultados del caso y del capítulo 9.
TipSoluciones razonadas
Los cantones con un componente de vigilancia cerca de 80 % o 90 % pueden cambiar; los de cobertura no, porque no dependen de esa semilla. Es una forma de ver qué parte de la clasificación es azar.
Con poblaciones pequeñas, la tasa es casi siempre 0 o muy alta; agregarla introduce ruido. Si se usa, conviene acumular varios años o calcularla a nivel provincial.
Cambia 95 y 90 en puntos_cobertura(). Cortes más bajos reducen el número de cantones en riesgo alto, pero no cambian el orden: el puntaje ordena mejor de lo que clasifica.
Agrupa personas por establecimiento. Con 50 a 200 niños por establecimiento, un niño cambia la cobertura en más de medio punto y la clasificación se vuelve inestable; convienen indicadores absolutos, como el número de niños sin SRP.
No hay una respuesta única. Una búsqueda nominal ataca exactamente a los niños sin dosis y deja una lista verificable; una campaña de seguimiento llega también a los no registrados y a los que tienen fallas vacunales, pero cuesta más. En C04, con vigilancia débil, el registro puede estar incompleto: un argumento a favor de la campaña allí y de la búsqueda nominal en el resto.
18.8 Autoevaluación
Responde antes de abrir cada respuesta. Si fallas una, vuelve a la sección correspondiente antes de continuar.
18.8.1 Comprobación
2. ¿Por qué el caso usa el cumplimiento de la notificación semanal además de la tasa de sospechosos?
Porque la tasa de sospechosos no se puede calcular
Porque la OPS prohíbe usar tasas
Porque en poblaciones pequeñas la tasa es inestable, y la notificación semanal existe aunque no haya casos
Porque la notificación semanal mide la cobertura
TipRespuesta de la pregunta 2
c. La notificación negativa indica si el sistema está mirando.
3. ¿Qué relación tiene el puntaje del caso con la herramienta de la OPS?
Es la herramienta oficial
Reemplaza a la herramienta oficial en cantones pequeños
Usa los mismos puntos de corte que la OPS
Es una simplificación didáctica; una evaluación real debe usar la herramienta oficial vigente
TipRespuesta de la pregunta 3
d. La herramienta de la OPS suma cinco componentes en una escala de 0 a 100.
4. Un cantón cambia de riesgo «medio» a «alto» si su cobertura baja dos puntos. ¿Cómo lo presentas?
Como riesgo alto, para ser prudente
Como cercano al corte: riesgo medio o alto según la precisión de la cobertura
Como riesgo medio, porque es el valor observado
Lo excluyes del informe
TipRespuesta de la pregunta 4
b. La sensibilidad muestra qué clasificaciones son sólidas y cuáles dependen de un corte.
18.8.2 Transferencia a tu trabajo
5. El cantón de mayor riesgo tiene además la vigilancia más débil. ¿Qué implica para el registro nominal?
Que el registro es más confiable
Que no hace falta vacunar
Que también puede estar incompleto, y una lista nominal no encontraría a todos los niños sin dosis
Que el riesgo está sobreestimado
TipRespuesta de la pregunta 5
c. La debilidad del sistema de información afecta a la vigilancia y al registro; es un argumento para acciones que lleguen a los no registrados.
6. ¿Qué limitación importante tiene una clasificación de riesgo construida solo con datos infantiles?
No informa sobre adolescentes y adultos susceptibles
No informa sobre los menores de un año
No puede ordenar cantones
No permite usar R
TipRespuesta de la pregunta 6
a. Los adultos susceptibles requieren otras fuentes, como encuestas serológicas o antecedentes de campañas.
Burton, A. et al. (2009). WHO and UNICEF estimates of national infant immunization coverage: methods and processes. Bulletin of the World Health Organization, 87(7), 535-541. https://doi.org/10.2471/BLT.08.053819
Jackson, M. L., & Nelson, J. C. (2013). The test-negative design for estimating influenza vaccine effectiveness. Vaccine, 31(17), 2165-2168.
Lopez Bernal, J., Cummins, S., & Gasparrini, A. (2017). Interrupted time series regression for the evaluation of public health interventions: a tutorial. International Journal of Epidemiology, 46, 348-355. https://doi.org/10.1093/ije/dyw098
Ministerio de Salud Pública del Ecuador. (2024). Vigilancia de eventos supuestamente atribuidos a la vacunación o inmunización (ESAVI) graves y de eventos adversos de interés especial (EVADIE).
Ministerio de Salud Pública del Ecuador. (2025). Norma técnica del Sistema Integrado de Vigilancia Epidemiológica (SIVE).
Orenstein, W. A. et al. (1985). Field evaluation of vaccine efficacy. Bulletin of the World Health Organization, 63(6), 1055-1068.
Organización Panamericana de la Salud. (2021). Manual de vigilancia de eventos supuestamente atribuibles a la vacunación o inmunización en la Región de las Américas.
pobecu contributors. (s. f.). pobecu: poblaciones ecuatorianas para análisis en R. Recuperado 31 de octubre de 2026, de https://github.com/f-slg/pobecu