Responde sin consultar el texto. Al terminar, vuelve a esta pregunta y comprueba si cambió tu respuesta.
1. Encuentras filas con la vacuna escrita como «HEXA», «Hexavalente» y «Hexavalente ». ¿Qué haces?
Eliminar las variantes minoritarias
Contarlas como vacunas distintas
Dejar el texto como está y filtrar por «Hexavalente»
Normalizarlas a un código con una tabla de equivalencias explícita
TipRespuesta de la pregunta 1
d. Normalizar con una tabla explícita conserva todas las dosis y documenta cada traducción. Filtrar por un solo texto perdería las variantes.
4.1 Objetivos y pregunta de trabajo
Al terminar este capítulo podrás:
aplicar una batería de controles de calidad a un registro nominal sin borrar filas a ciegas;
detectar filas duplicadas y personas registradas con más de un identificador;
normalizar los nombres de las vacunas;
clasificar cada dosis como válida, nula o fuera de edad según el esquema nacional;
dejar escrita cada decisión de limpieza para que otra persona pueda revisarla.
Pregunta de trabajo: el registro del distrito tiene 28.000 filas. ¿Cuántas dosis válidas contiene y qué hiciste con las demás?
4.2 El principio: marcar antes de borrar
Limpiar no es borrar lo que molesta. Cada fila problemática representa una de tres situaciones: un error de digitación, un problema real de la atención (una dosis aplicada antes de tiempo) o una persona que el sistema no reconoce como la misma. Si se borra sin mirar, se pierde la diferencia entre las tres.
Por eso el libro separa dos pasos:
Controlar:controlar_registro() agrega columnas lógicas p_* que marcan cada problema. No elimina nada.
Decidir: el analista resuelve qué hacer con cada tipo de problema y lo escribe en código, con un registro de decisiones.
«HEXA» y «Hexavalente» son la misma vacuna, igual que «ROTA » (con un espacio final) y «Rotavirus», o «Triple viral» y «SRP». Si contamos sin normalizar, partimos cada serie en dos.
4.4 Paso 2. Normalizar los nombres de las vacunas
normalizar_vacuna() quita espacios, mayúsculas y tildes, y traduce cada variante a un código del esquema mediante una tabla de equivalencias explícita:
[1] "HEXAVALENTE" "HEXAVALENTE" "SRP"         "HB0"         "BOPV"
[6] NA
La pentavalente devuelve NA a propósito. No es una variante de la hexavalente, sino otra vacuna que el esquema de 2026 ya no usa. Traducirla en silencio cambiaría el significado del dato. Una equivalencia se agrega a la tabla solo cuando se sabe que es correcta.
vacuna_desconocida: el nombre no corresponde a ningún código. Aquí es cero porque todas las variantes se tradujeron.
fecha_faltante: sin fecha de vacunación o de nacimiento no se puede evaluar la dosis.
antes_nacimiento: fecha imposible. Suele ser un año mal digitado o un día y un mes invertidos.
fecha_futura: posterior a la fecha de corte. Puede ser un error o una dosis cargada después del corte con fecha mal escrita.
dosis_fuera_esquema: una dosis que el esquema no contempla, como una cuarta dosis de rotavirus.
duplicado_exacto: misma persona, vacuna, dosis y fecha. Es la doble carga del mismo formulario.
dosis_repetida: misma persona, vacuna y dosis, pero en otra fecha. No es una copia: puede ser una dosis nula que se repitió correctamente o una dosis mal numerada. Requiere revisión.
Los controles encuentran exactamente las fechas imposibles, futuras y faltantes, y los duplicados exactos. Las dosis con intervalo corto no aparecen aquí porque no son errores de digitación, sino dosis aplicadas antes de tiempo: se detectan en el paso 5. Las personas con dos identificadores tampoco aparecen, porque sus filas no se repiten. Requieren otra técnica.
4.6 Paso 4. Personas con más de un identificador
Una misma niña puede tener dos identificadores si la registraron sin documento en un establecimiento y con documento en otro. Ninguna fila está duplicada, pero sus dosis quedan repartidas y ambos «niños» parecen tener el esquema incompleto. Para encontrarlos se buscan personas con los mismos datos de identificación y distinto identificador:
      id_persona iniciales fecha_nacimiento sexo canton grupo
3515     P001523       ACU       2023-08-12    M    C01     1
9244     P900001       ACU       2023-08-12    M    C01     1
24482    P001540       BUV       2023-12-23    F    C05     2
28010    P900008       BUV       2023-12-23    F    C05     2
15642    P001664       EWE       2025-07-21    M    C02     3
16300    P900003       EWE       2025-07-21    M    C02     3
c(grupos =length(unique(candidatos$grupo)))
grupos
     8
Es una coincidencia determinista: exige que iniciales, fecha de nacimiento, sexo y cantón sean idénticos. Encuentra los casos que el generador introdujo, pero en un registro real fallaría si la fecha de nacimiento está mal digitada en una de las dos fichas, y podría unir a dos gemelos con las mismas iniciales. Por eso el resultado es una lista de candidatos para revisar, no una fusión automática. Cuando la revisión confirma un par, la fusión se escribe como una tabla de equivalencias:
# Decisión documentada: los candidatos revisados se fusionan en el identificador más antiguo.equivalencias <-do.call(rbind, lapply(split(candidatos, candidatos$grupo), function(g) {data.frame(id_original = g$id_persona, id_unificado =min(g$id_persona))}))controlado$id_persona <-ifelse(controlado$id_persona %in% equivalencias$id_original, equivalencias$id_unificado[match(controlado$id_persona, equivalencias$id_original)], controlado$id_persona)length(unique(controlado$id_persona))
[1] 2000
4.7 Paso 5. Decidir y evaluar cada dosis
Ahora aplicamos las decisiones. Las escribimos como una tabla, no solo como código, porque esa tabla acompañará al informe:
decisiones <-data.frame(problema =c("antes_nacimiento", "fecha_futura", "fecha_faltante", "duplicado_exacto","dosis_repetida", "persona_con_dos_id"),decision =c("Excluir y devolver al establecimiento para corrección","Excluir del análisis con este corte","Excluir; no se puede evaluar edad ni intervalo","Conservar una sola fila","Revisar caso por caso (ninguno en este registro)","Fusionar candidatos revisados en el identificador más antiguo"))knitr::kable(decisiones, col.names =c("Problema", "Decisión"))
Problema
Decisión
antes_nacimiento
Excluir y devolver al establecimiento para corrección
fecha_futura
Excluir del análisis con este corte
fecha_faltante
Excluir; no se puede evaluar edad ni intervalo
duplicado_exacto
Conservar una sola fila
dosis_repetida
Revisar caso por caso (ninguno en este registro)
persona_con_dos_id
Fusionar candidatos revisados en el identificador más antiguo
# Tras la fusión de identificadores, vuelve a buscar duplicados exactos.controlado <-controlar_registro(controlado[names(registro)], fecha_corte, esquema)limpio <- controlado[!controlado$con_problema, ]c(filas_iniciales =nrow(registro), filas_excluidas =sum(controlado$con_problema),filas_limpias =nrow(limpio))
Con el registro limpio, evaluar_dosis() compara cada dosis con las reglas del esquema: edad mínima, edad límite e intervalo desde la dosis anterior de la misma serie, con el margen de cuatro días del manual (Ministerio de Salud Pública del Ecuador, 2026b, Sección 6.2).
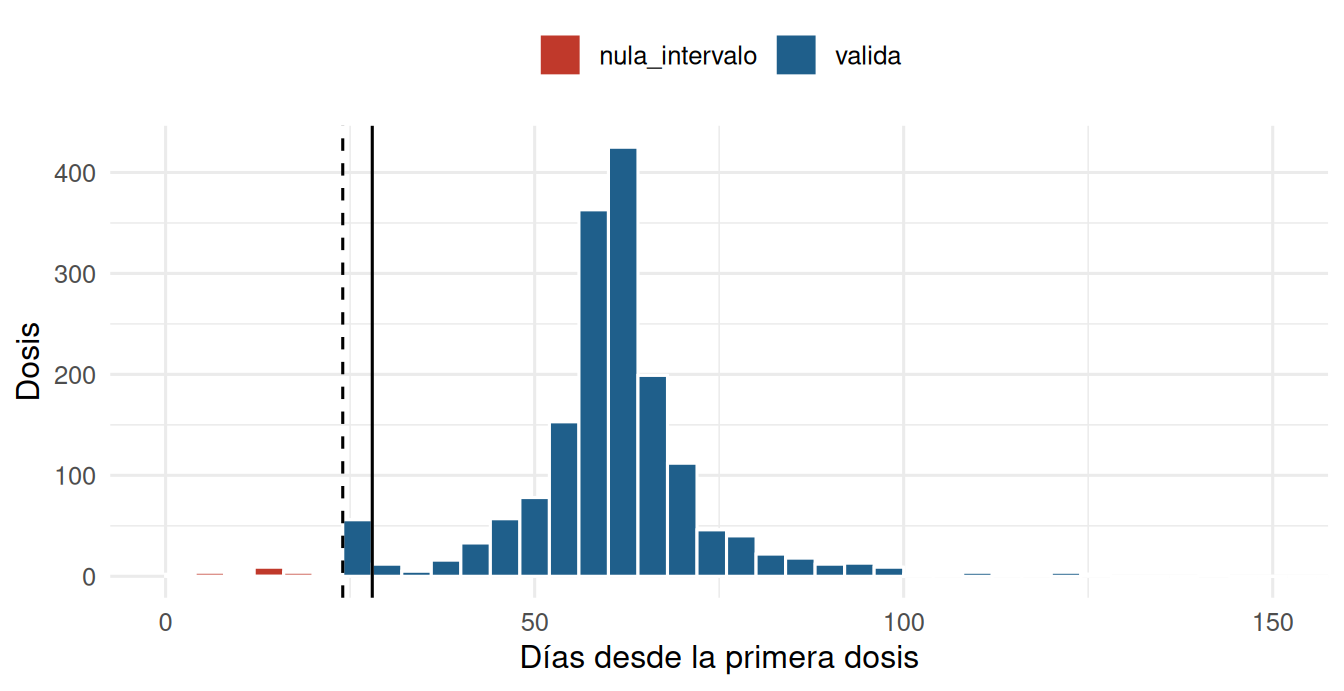
Las dosis nulas por intervalo se concentran en las segundas dosis de hexavalente y neumococo, donde el generador adelantó la aplicación 45 días. En un registro real, esta tabla es una alerta para el establecimiento. Esos niños necesitan una dosis adicional para completar la serie: una dosis nula no protege como se espera, aunque esté en el carné.
segundas <- evaluadas[evaluadas$vacuna_codigo =="HEXAVALENTE"& evaluadas$dosis ==2, ]ggplot(segundas, aes(dias_desde_anterior, fill = estado)) +geom_histogram(binwidth =4, boundary =0, colour ="white") +geom_vline(xintercept =28) +geom_vline(xintercept =24, linetype =2) +scale_fill_manual(values =c(valida ="#1f5f8b", nula_intervalo ="#c0392b")) +coord_cartesian(xlim =c(0, 150)) +labs(x ="Días desde la primera dosis", y ="Dosis", fill =NULL) +theme_minimal(base_size =12) +theme(legend.position ="top")
Figura 4.1: Días entre la primera y la segunda dosis de hexavalente. La línea continua marca el intervalo mínimo de 28 días y la discontinua el margen de 24 días.
La respuesta no es un solo número: es un balance en el que cada fila recibida termina en una categoría y las sumas cuadran. El stopifnot() final garantiza que ninguna fila se perdió sin explicación. Este balance, junto con la tabla de decisiones, es lo primero que debe acompañar a cualquier cobertura calculada con el registro.
4.9 Limitaciones
La coincidencia determinista de personas no detecta pares con errores de digitación en la fecha de nacimiento. Los métodos probabilísticos de enlace de registros quedan fuera de este capítulo.
El margen de cuatro días se aplica a los intervalos entre dosis, como dice el manual. Aplicarlo también a la edad mínima sería otra decisión técnica, y debería documentarse.
El registro sintético no reproduce todos los problemas reales: personas fallecidas o emigradas, cambios de residencia y dosis aplicadas en el sector privado no registradas.
4.10 Ejercicios
Variante nueva. Agrega al registro tres filas con la vacuna escrita «Neumococo 13» y comprueba si normalizar_vacuna() las reconoce. Si no las reconoce, ¿cómo y dónde la agregarías?
Sin margen. Evalúa el registro limpio con margen_dias = 0. ¿Cuántas dosis válidas pasan a ser nulas? ¿Qué implicaría para los niños?
Edad límite. Construye un niño que recibe la primera dosis de rotavirus a los 4 meses y 3 días. ¿Qué estado le asigna evaluar_dosis()? ¿Qué debería hacer el vacunador?
Balance por cantón. Repite el balance de la pregunta de trabajo para cada cantón. ¿Hay alguno con más exclusiones por calidad que los demás?
Gemelos. Explica qué pasaría con dos gemelos que comparten iniciales en la búsqueda de personas duplicadas. ¿Qué dato adicional evitaría fusionarlos?
TipSoluciones razonadas
normalizar_vacuna("Neumococo 13") quita el espacio y busca NEUMOCOCO13, que sí está en la tabla de equivalencias. Si una variante no estuviera, se agrega a equivalencias dentro de normalizar_vacuna() y se añade un caso a tests/pruebas_esquema.R.
table(evaluar_dosis(limpio, esquema, margen_dias = 0)$estado). Las dosis que antes estaban en_margen pasan a nula_intervalo. Esos niños necesitarían una dosis adicional que el manual no exige, porque el margen existe precisamente para no repetir dosis aplicadas unos días antes.
Con nacimiento el 1 de enero y vacunación el 4 de mayo, el estado es fuera_de_edad_limite. El vacunador no debe aplicar esa dosis y el niño continúa el esquema sin rotavirus. En el registro, la dosis indica un error de práctica que hay que notificar.
tapply(controlado$con_problema, controlado$canton, mean) da la proporción de exclusiones por cantón. En el registro sintético los errores se inyectan al azar, así que las diferencias son pequeñas; en un registro real, un cantón con muchas exclusiones necesita apoyo en digitación.
Si comparten iniciales, fecha, sexo y cantón, quedan como candidatos a fusión. Un dato adicional como la cédula, el número de historia clínica o el orden de nacimiento evitaría fusionarlos. Por eso los candidatos se revisan antes de fusionar.
4.11 Autoevaluación
Responde antes de abrir cada respuesta. Si fallas una, vuelve a la sección correspondiente antes de continuar.
4.11.1 Comprobación
2. ¿Cuál es la diferencia entre un duplicado exacto y una persona con dos identificadores?
Ninguna; ambos se eliminan con duplicated()
El duplicado exacto repite persona, vacuna, dosis y fecha; la persona con dos identificadores no repite filas y reparte sus dosis entre dos códigos
El duplicado exacto solo ocurre en consolidados
La persona con dos identificadores siempre tiene fechas imposibles
TipRespuesta de la pregunta 2
b. duplicated() encuentra filas repetidas, pero no a una persona con dos códigos. Para eso se comparan los datos de identificación.
3. ¿Por qué posibles_duplicados_persona() devuelve candidatos en lugar de fusionar automáticamente?
Porque R no permite modificar identificadores
Porque la coincidencia puede unir a personas distintas, como gemelos, y debe revisarse
Porque los candidatos nunca son la misma persona
Porque la fusión se hace en el consolidado
TipRespuesta de la pregunta 3
b. Una fusión equivocada mezcla los esquemas de dos niños. La revisión humana y una tabla de equivalencias documentada evitan ese error.
4. Una dosis aparece como «nula_intervalo». Para el niño, esto significa que:
El registro tiene un error de digitación que se corrige borrando la fila
No necesita ninguna acción
La dosis se aplicó antes del intervalo mínimo y necesita una dosis adicional para completar la serie
Debe reiniciar todo el esquema desde la primera dosis
TipRespuesta de la pregunta 4
c. Una dosis nula no cuenta para la serie. El manual no exige reiniciar el esquema: basta aplicar la dosis que falta respetando el intervalo.
4.11.2 Transferencia a tu trabajo
5. Al terminar la limpieza, ¿qué debe acompañar a la cobertura que reportes?
El balance de filas recibidas, excluidas, válidas y nulas, y la tabla de decisiones
Solo el porcentaje final
El registro nominal completo
Una captura de pantalla del código
TipRespuesta de la pregunta 5
a. El balance y las decisiones permiten que otra persona entienda y reproduzca la cifra sin acceder a datos personales.
6. Un establecimiento concentra muchas dosis nulas por intervalo en segundas dosis. ¿Qué indica y qué harías?
Es ruido aleatorio y se ignora
Hay que excluir ese establecimiento del cálculo de cobertura
Que sus datos son falsos
Un posible problema de práctica, por ejemplo citas mal calculadas; se informa para capacitar y buscar a los niños que necesitan otra dosis
TipRespuesta de la pregunta 6
d. Las dosis nulas son información del programa: señalan niños sin protección completa y prácticas que pueden corregirse.
4.12 Ideas que debes conservar
Primero se marca y después se decide; cada decisión queda escrita en una tabla.
Los duplicados exactos y las personas con dos identificadores son problemas distintos y necesitan técnicas distintas.
Una dosis nula por intervalo no es un error de datos: es un niño que necesita otra dosis.
El balance final debe cuadrar: cada fila recibida termina en una categoría explicada.
Burton, A. et al. (2009). WHO and UNICEF estimates of national infant immunization coverage: methods and processes. Bulletin of the World Health Organization, 87(7), 535-541. https://doi.org/10.2471/BLT.08.053819
Jackson, M. L., & Nelson, J. C. (2013). The test-negative design for estimating influenza vaccine effectiveness. Vaccine, 31(17), 2165-2168.
Lopez Bernal, J., Cummins, S., & Gasparrini, A. (2017). Interrupted time series regression for the evaluation of public health interventions: a tutorial. International Journal of Epidemiology, 46, 348-355. https://doi.org/10.1093/ije/dyw098
Ministerio de Salud Pública del Ecuador. (2024). Vigilancia de eventos supuestamente atribuidos a la vacunación o inmunización (ESAVI) graves y de eventos adversos de interés especial (EVADIE).
Ministerio de Salud Pública del Ecuador. (2025). Norma técnica del Sistema Integrado de Vigilancia Epidemiológica (SIVE).
Orenstein, W. A. et al. (1985). Field evaluation of vaccine efficacy. Bulletin of the World Health Organization, 63(6), 1055-1068.
Organización Panamericana de la Salud. (2021). Manual de vigilancia de eventos supuestamente atribuibles a la vacunación o inmunización en la Región de las Américas.
pobecu contributors. (s. f.). pobecu: poblaciones ecuatorianas para análisis en R. Recuperado 31 de octubre de 2026, de https://github.com/f-slg/pobecu